nthropic
Differenza tra Machine Learning e Deep Learning
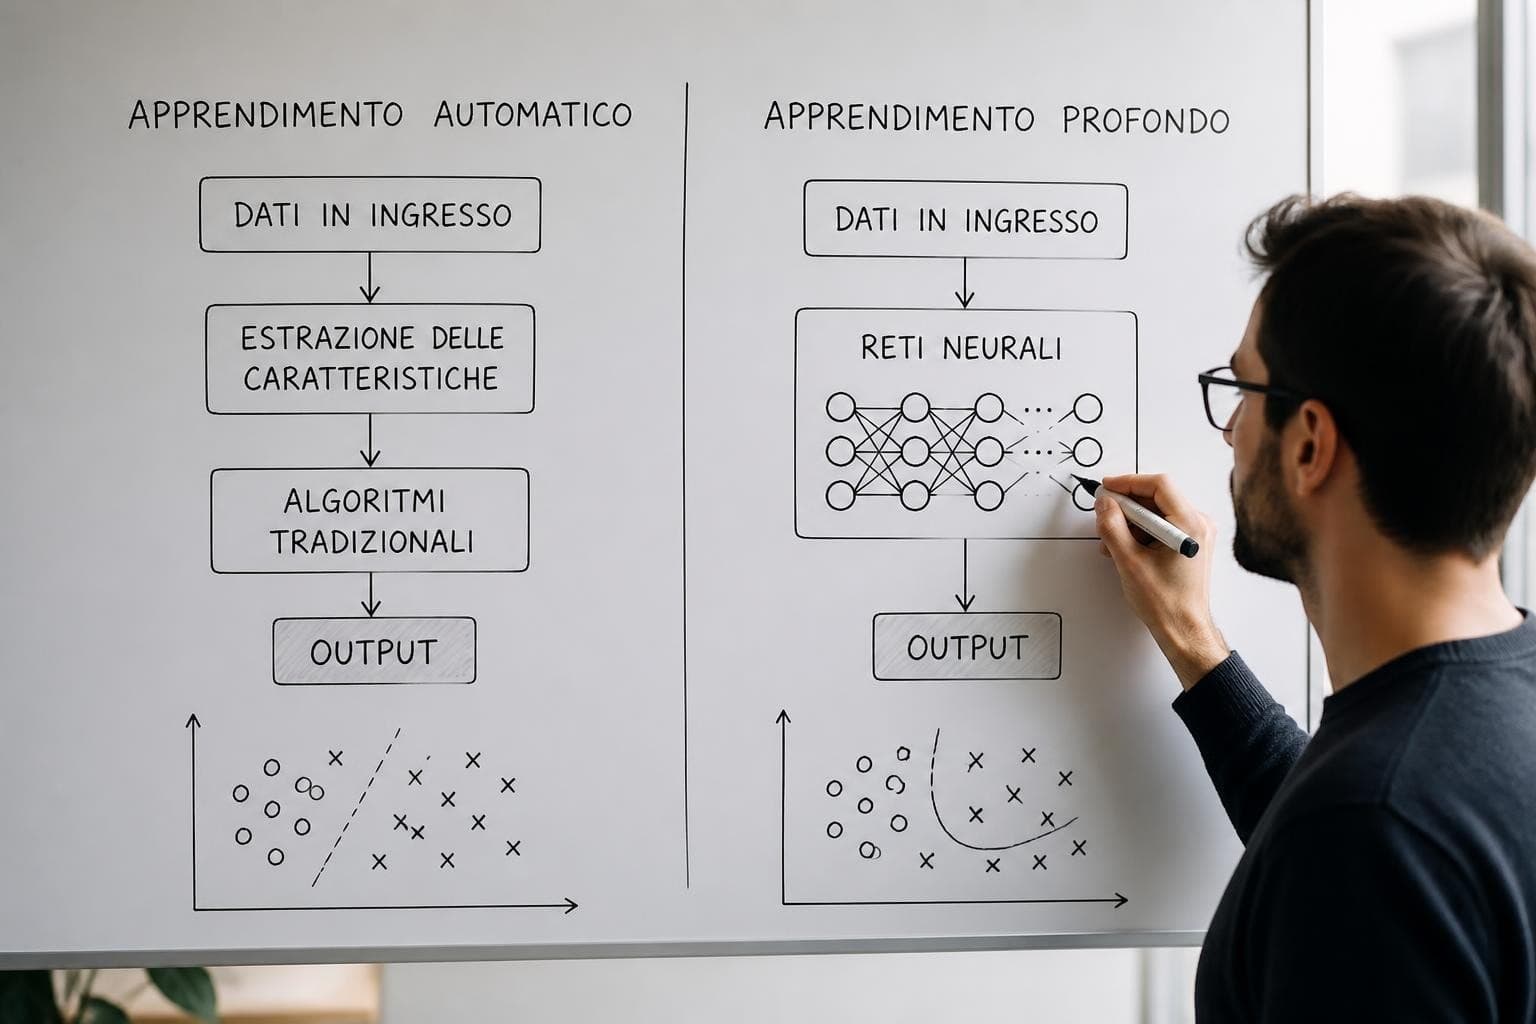
L'intelligenza artificiale sta trasformando il panorama tecnologico globale, e comprendere la differenza tra machine learning e deep learning è fondamentale per professionisti, studenti e aziende che vogliono orientarsi in questo settore. Entrambe le tecnologie rappresentano sottocampi dell'intelligenza artificiale, ma si distinguono per architettura, capacità computazionale e applicazioni. Questa guida professionale esplora in dettaglio le caratteristiche distintive, i vantaggi e gli scenari d'uso ideali per ciascuna tecnologia, fornendo un quadro completo per comprendere quale approccio adottare in base alle esigenze specifiche.
Fondamenti del Machine Learning
Il machine learning rappresenta una branca dell'intelligenza artificiale che consente ai sistemi di apprendere dai dati senza essere esplicitamente programmati per ogni singola situazione. Gli algoritmi di machine learning identificano pattern, relazioni e tendenze attraverso l'analisi di dataset, migliorando progressivamente le loro prestazioni con l'esperienza.
Tipologie di Machine Learning
Gli approcci principali del machine learning si suddividono in tre categorie fondamentali:
- Apprendimento supervisionato: l'algoritmo viene addestrato su dati etichettati, dove ogni input è associato a un output corretto
- Apprendimento non supervisionato: il sistema identifica pattern nascosti in dati non etichettati
- Apprendimento per rinforzo: l'algoritmo apprende attraverso tentativi ed errori, ricevendo ricompense o penalità
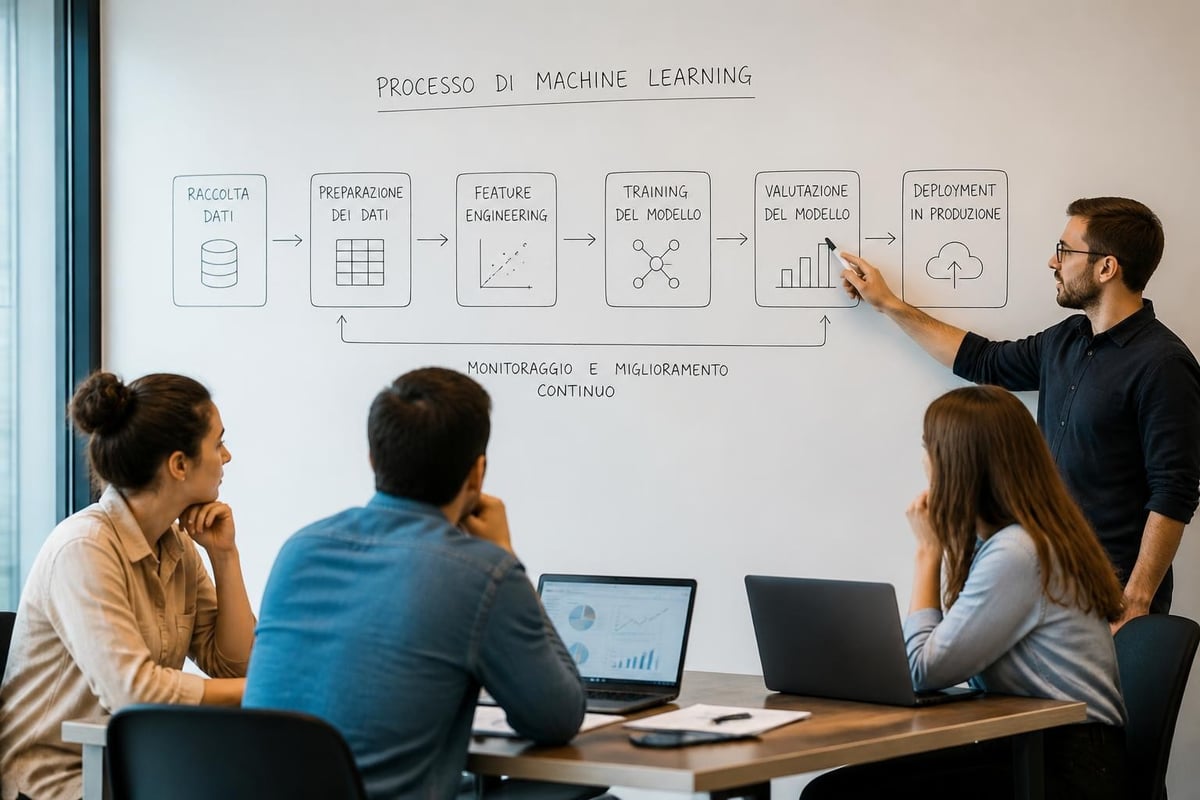
Le applicazioni pratiche del machine learning spaziano dalla classificazione di email spam al riconoscimento di frodi bancarie, dalla previsione delle vendite all'ottimizzazione delle campagne marketing. La caratteristica distintiva è la necessità di feature engineering, ovvero l'estrazione manuale delle caratteristiche rilevanti dai dati grezzi.
Algoritmi Tradizionali di Machine Learning
Gli algoritmi classici richiedono intervento umano per definire quali caratteristiche analizzare. Tra i più utilizzati troviamo:
| Algoritmo | Tipologia | Applicazione Principale |
|---|---|---|
| Regressione Lineare | Supervisionato | Previsione valori numerici |
| Decision Tree | Supervisionato | Classificazione e decisioni |
| Random Forest | Supervisionato | Analisi predittiva complessa |
| K-Means | Non supervisionato | Segmentazione clienti |
| Support Vector Machine | Supervisionato | Classificazione binaria |
Questi algoritmi eccellono quando i dataset sono di dimensioni moderate e le relazioni tra variabili sono relativamente lineari. La guida pratica alle differenze tra machine learning e deep learning offre ulteriori approfondimenti su questi aspetti.
Architettura del Deep Learning
Il deep learning rappresenta un sottoinsieme specializzato del machine learning che utilizza reti neurali artificiali con molteplici livelli nascosti. Questa architettura stratificata consente al sistema di apprendere rappresentazioni gerarchiche dei dati, eliminando la necessità di feature engineering manuale.
Struttura delle Reti Neurali Profonde
Le reti neurali deep learning sono composte da layer interconnessi che processano informazioni in modo sequenziale:
- Input layer: riceve i dati grezzi senza preprocessamento
- Hidden layers: elaborano progressivamente le informazioni, estraendo feature sempre più astratte
- Output layer: produce la previsione o classificazione finale
Ogni neurone artificiale applica una funzione di attivazione ai dati in ingresso, permettendo alla rete di modellare relazioni non lineari complesse. Il numero di layer nascosti determina la "profondità" della rete, da cui deriva il termine deep learning.
La differenza sostanziale rispetto al machine learning tradizionale risiede proprio nella capacità di apprendimento automatico delle feature. Come evidenziato da IBM nella loro panoramica sul deep learning, le reti neurali multistrato identificano autonomamente quali caratteristiche sono rilevanti per il compito assegnato.
Tipologie di Reti Neurali
Diverse architetture di deep learning sono state sviluppate per specifiche applicazioni:
- Convolutional Neural Networks (CNN): eccellono nel riconoscimento di immagini e video
- Recurrent Neural Networks (RNN): ideali per dati sequenziali come testo e serie temporali
- Generative Adversarial Networks (GAN): utilizzate per generare contenuti sintetici realistici
- Transformer: dominano nell'elaborazione del linguaggio naturale
Comprendere la differenza tra machine learning e deep learning diventa cruciale quando si deve scegliere l'architettura appropriata per un progetto specifico.
Confronto Diretto: Machine Learning vs Deep Learning
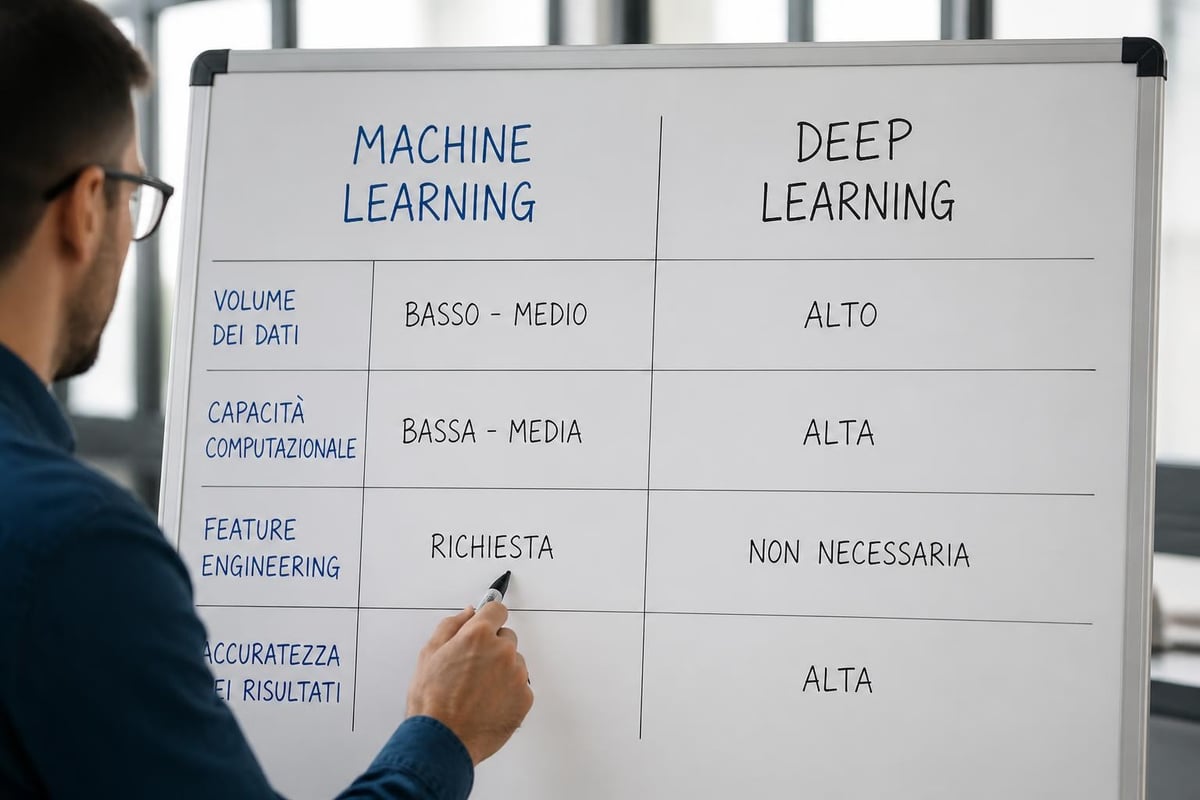
La differenza tra machine learning e deep learning si manifesta in molteplici dimensioni operative e tecnologiche.
Requisiti di Dati e Risorse
| Aspetto | Machine Learning | Deep Learning |
|---|---|---|
| Volume dati necessario | 10K - 100K record | 100K - milioni di record |
| Potenza computazionale | CPU standard | GPU/TPU specializzate |
| Tempo di training | Ore/giorni | Giorni/settimane |
| Costo infrastruttura | Moderato | Elevato |
| Interpretabilità | Alta | Bassa (black box) |
Il machine learning tradizionale funziona efficacemente con dataset più piccoli e richiede meno risorse computazionali. Gli algoritmi classici possono essere eseguiti su hardware standard, rendendoli accessibili anche per progetti con budget limitati.
Il deep learning, al contrario, richiede dataset massivi per evitare l'overfitting e necessita di GPU potenti per accelerare i calcoli matriciali. Tuttavia, questa maggiore complessità si traduce in prestazioni superiori per compiti ad alta complessità.
Prestazioni e Applicazioni
Il machine learning eccelle in scenari dove:
- Il dataset è strutturato e di dimensioni moderate
- Le relazioni tra variabili sono relativamente semplici
- L'interpretabilità dei risultati è prioritaria
- Le risorse computazionali sono limitate
Il deep learning dimostra superiorità quando:
- I dati sono non strutturati (immagini, audio, testo)
- Le relazioni sono altamente non lineari e complesse
- La quantità di dati disponibili è massiccia
- L'accuratezza è più importante dell'interpretabilità
AWS confronta in dettaglio queste tecnologie, evidenziando come il deep learning abbia rivoluzionato campi come la visione artificiale e l'elaborazione del linguaggio naturale.
Applicazioni Pratiche nel Mondo Reale
Analizzare le applicazioni concrete aiuta a comprendere meglio la differenza tra machine learning e deep learning in contesti operativi.
Casi d'Uso del Machine Learning
Le implementazioni tradizionali di machine learning includono:
- Sistemi di raccomandazione: suggerimenti personalizzati basati su preferenze storiche
- Rilevamento frodi: identificazione di transazioni anomale in tempo reale
- Manutenzione predittiva: previsione di guasti in macchinari industriali
- Ottimizzazione prezzi: strategie dinamiche basate su domanda e concorrenza
- Churn prediction: identificazione di clienti a rischio abbandono
Questi scenari beneficiano di algoritmi efficienti che operano su dati tabulari strutturati, dove le feature possono essere definite con precisione da esperti del dominio.
Applicazioni Avanzate del Deep Learning
Il deep learning ha abilitato innovazioni rivoluzionarie:
- Riconoscimento vocale: assistenti virtuali che comprendono linguaggio naturale
- Diagnosi medica: analisi di imaging radiologico con accuratezza comparabile agli specialisti
- Veicoli autonomi: elaborazione in tempo reale di sensori multipli per la navigazione
- Traduzione automatica: sistemi neurali che catturano sfumature linguistiche
- Generazione contenuti: creazione di testi, immagini e video sintetici realistici
La complessità intrinseca di questi compiti richiede l'apprendimento automatico di rappresentazioni gerarchiche che solo il deep learning può fornire. Andrea Minini spiega con esempi pratici come queste tecnologie si differenziano nelle applicazioni quotidiane.
Scelta della Tecnologia Appropriata
Decidere tra machine learning e deep learning richiede un'analisi strategica di molteplici fattori.
Criteri Decisionali
Valutate questi elementi prima di scegliere l'approccio:
- Natura dei dati: strutturati vs non strutturati
- Volume disponibile: migliaia vs milioni di record
- Budget computazionale: hardware standard vs infrastruttura GPU
- Timeline del progetto: settimane vs mesi
- Necessità di interpretabilità: decisioni critiche richiedono trasparenza
- Competenze del team: expertise statistico vs conoscenza deep learning
Per progetti con dati tabulari e risorse limitate, il machine learning tradizionale offre il miglior rapporto efficacia/costi. Per sfide che coinvolgono percezione visiva, comprensione linguistica o pattern estremamente complessi, il deep learning diventa necessario.
Approccio Ibrido
Molte soluzioni enterprise combinano entrambe le tecnologie:
| Componente | Tecnologia | Funzione |
|---|---|---|
| Feature extraction | Deep Learning | Estrazione automatica caratteristiche |
| Classificazione finale | Machine Learning | Decision tree interpretabile |
| Preprocessing | Machine Learning | Pulizia e normalizzazione dati |
| Pattern recognition | Deep Learning | Identificazione anomalie complesse |
Questo approccio ibrido massimizza i vantaggi di ciascuna tecnologia, bilanciando accuratezza, interpretabilità e efficienza computazionale.
Formazione Professionale e Competenze Richieste
Comprendere la differenza tra machine learning e deep learning è il primo passo per acquisire competenze spendibili nel mercato del lavoro.
Percorsi di Apprendimento
Le competenze fondamentali per il machine learning includono:
- Statistica e probabilità
- Algebra lineare
- Programmazione Python/R
- Algoritmi classici (regressione, clustering, alberi decisionali)
- Feature engineering e data preprocessing
Per il deep learning sono necessarie conoscenze aggiuntive:
- Architetture di reti neurali (CNN, RNN, Transformer)
- Framework specializzati (TensorFlow, PyTorch)
- Ottimizzazione e backpropagation
- Gestione GPU e calcolo parallelo
- Tecniche di regolarizzazione e transfer learning
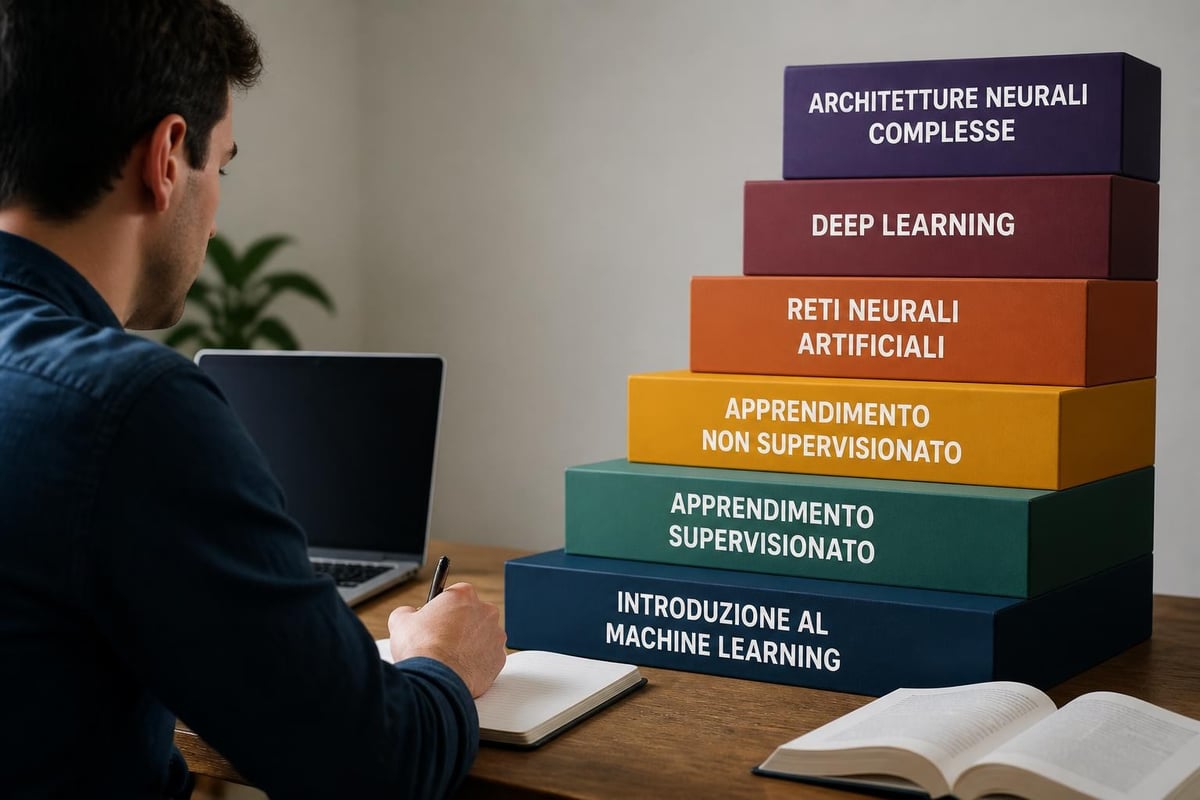
Per chi desidera sviluppare competenze pratiche immediatamente spendibili, programmi formativi strutturati rappresentano la soluzione ideale. Il Master Claude Architect Developer offre un percorso part-time di 6 mesi che combina teoria e pratica operativa, permettendo di acquisire competenze concrete anche partendo da zero, compatibilmente con impegni lavorativi esistenti.
Certificazioni e Competenze Verificabili
Le certificazioni professionali validano le competenze acquisite:
- Machine Learning: certificazioni Google Cloud ML Engineer, AWS Machine Learning Specialty
- Deep Learning: Deep Learning Specialization (Coursera), TensorFlow Developer Certificate
- Competenze trasversali: data engineering, MLOps, deployment produttivo
Il mercato richiede professionisti che non solo comprendano la differenza tra machine learning e deep learning, ma sappiano anche implementare soluzioni end-to-end, dalla prototipazione al deployment scalabile.
Tendenze Future e Evoluzione Tecnologica
Il panorama dell'intelligenza artificiale evolve rapidamente, ridefinendo continuamente i confini tra machine learning e deep learning.
Innovazioni Emergenti
Le tecnologie emergenti stanno trasformando entrambi i campi:
- AutoML: automazione della selezione algoritmi e ottimizzazione iperparametri
- Federated Learning: training distribuito preservando privacy dei dati
- Neural Architecture Search: progettazione automatica di reti neurali ottimali
- Quantum Machine Learning: integrazione con computing quantistico
- Edge AI: deployment di modelli deep learning su dispositivi con risorse limitate
Queste innovazioni riducono progressivamente la distanza tecnica tra machine learning e deep learning, rendendo le tecnologie avanzate più accessibili.
Implicazioni per Professionisti e Aziende
Le organizzazioni devono considerare:
- Investimento in infrastruttura: bilanciare cloud e risorse on-premise
- Sviluppo competenze: formazione continua del team tecnico
- Governance dei dati: qualità e disponibilità dataset per training
- Etica e compliance: trasparenza algoritmica e regolamentazione AI
- ROI misurabile: metriche business chiare per progetti AI
La comprensione approfondita della differenza tra machine learning e deep learning diventa asset strategico per guidare decisioni tecnologiche informate. Per approfondire ulteriormente le differenze tra machine learning e deep learning, risorse specializzate offrono analisi dettagliate delle implicazioni pratiche.
Implementazione e Best Practices
L'implementazione efficace richiede metodologie strutturate indipendentemente dalla tecnologia scelta.
Pipeline di Sviluppo
Un flusso di lavoro professionale comprende:
- Problem definition: definizione obiettivi business e metriche successo
- Data collection: acquisizione dataset rappresentativi
- Exploratory analysis: comprensione statistica dei dati
- Feature engineering (ML) o architecture selection (DL)
- Model training: addestramento con validation set
- Evaluation: test su dati mai visti durante training
- Deployment: integrazione in ambiente produttivo
- Monitoring: tracking performance e data drift
Le best practices includono versioning dei dataset, gestione esperimenti riproducibili e testing rigoroso prima del rilascio.
Ottimizzazione delle Performance
Tecniche per massimizzare l'efficacia:
- Ensemble methods: combinazione di modelli multipli per ridurre varianza
- Transfer learning: riutilizzo di modelli pre-addestrati per nuovi compiti
- Data augmentation: generazione sintetica di esempi training
- Hyperparameter tuning: ottimizzazione sistematica dei parametri
- Model compression: riduzione dimensioni per deployment efficiente
La scelta tra machine learning e deep learning influenza profondamente quale tecnica di ottimizzazione risulta più efficace.
Strumenti e Framework Tecnologici
L'ecosistema software offre strumenti specializzati per ciascuna tecnologia.
Librerie per Machine Learning
Gli strumenti principali includono:
| Framework | Linguaggio | Specializzazione |
|---|---|---|
| Scikit-learn | Python | Algoritmi classici completi |
| XGBoost | Python/R | Gradient boosting ottimizzato |
| LightGBM | Python/R | Training veloce su grandi dataset |
| Caret | R | Pipeline ML integrate |
| H2O.ai | Multi-linguaggio | AutoML enterprise |
Questi framework semplificano l'implementazione di algoritmi tradizionali con API intuitive e documentazione estesa.
Piattaforme Deep Learning
Le tecnologie per reti neurali richiedono framework più sofisticati:
- TensorFlow: ecosistema completo con deployment flessibile
- PyTorch: preferito per ricerca e prototipazione rapida
- Keras: API ad alto livello per sviluppo rapido
- JAX: trasformazioni automatiche e differenziazione
- MXNet: scalabilità cloud-native
La comprensione della differenza tra machine learning e deep learning guida la selezione dello stack tecnologico appropriato. Gli esperti di Aladia evidenziano come la formazione pratica su questi strumenti sia fondamentale per trasformare la conoscenza teorica in competenze operative.
Considerazioni Economiche e ROI
L'analisi costi-benefici deve considerare l'intero ciclo di vita del progetto.
Struttura dei Costi
Le componenti economiche principali:
- Infrastruttura: hardware, cloud computing, storage
- Risorse umane: data scientist, ML engineer, domain expert
- Dati: acquisizione, etichettatura, pulizia
- Software: licenze, framework, tool di monitoring
- Manutenzione: aggiornamenti modelli, retraining periodico
Il machine learning tradizionale presenta costi infrastrutturali significativamente inferiori, mentre il deep learning richiede investimenti maggiori bilanciati da performance superiori su compiti complessi.
Misurazione del Valore
Metriche per valutare il successo:
- Accuratezza predittiva: miglioramento rispetto a baseline
- Efficienza operativa: riduzione tempi o costi processuali
- Revenue impact: incremento vendite o retention clienti
- Risk mitigation: riduzione frodi o errori costosi
- Time to market: velocità deployment nuove funzionalità
La scelta tra machine learning e deep learning deve allinearsi con gli obiettivi strategici e i vincoli economici dell'organizzazione.
Sfide e Limitazioni
Entrambe le tecnologie presentano criticità specifiche da considerare.
Problematiche del Machine Learning
Le sfide principali includono:
- Feature engineering intensivo: richiede expertise dominio specifico
- Scalabilità limitata: performance plateau su dati massivi
- Generalizzazione: difficoltà con pattern altamente complessi
- Bias algoritmico: discriminazione nascosta nei dati storici
Criticità del Deep Learning
Gli ostacoli tipici sono:
- Opacità decisionale: difficoltà interpretazione logica interna
- Data hunger: necessità di dataset enormi
- Costi computazionali: infrastruttura specializzata costosa
- Instabilità training: sensibilità a iperparametri e inizializzazione
- Overfitting: memorizzazione anziché generalizzazione
Comprendere queste limitazioni permette di applicare la tecnologia appropriata minimizzando i rischi. MAC Formazione evidenzia come queste considerazioni pratiche influenzino la scelta tecnologica nelle implementazioni reali.
La comprensione della differenza tra machine learning e deep learning rappresenta una competenza strategica per professionisti e organizzazioni che vogliono sfruttare il potenziale dell'intelligenza artificiale. Entrambe le tecnologie offrono valore significativo in contesti appropriati, e la scelta consapevole dipende da obiettivi, risorse e tipologia di dati disponibili. Aladia · High Scool Education, partner ufficiale di Anthropic, offre percorsi formativi online completi che spaziano dall'istruzione superiore ai master specialistici e alla formazione aziendale personalizzata, permettendo a studenti e professionisti di acquisire competenze concrete nell'intelligenza artificiale e nelle sue applicazioni pratiche. Iniziate oggi il vostro percorso verso l'eccellenza nell'AI con programmi flessibili compatibili con gli impegni lavorativi.